LLMをAPI経由で呼び出すだけでは、エージェントが完成したとは言えません。モデルは基本的に入力を受け取り、出力を生成し、そこで処理を終了します。
ファイルを読み、コードを実行し、複数のステップにまたがるタスクを進め、現在の作業状態を記憶し、自分の結果を検証できるようにするには、モデルの周囲にソフトウェアレイヤーが必要です。
このレイヤーを Agent Harness と呼ぶことができます。
Agent Harnessは、次の6つの主要要素で考えると理解しやすくなります。
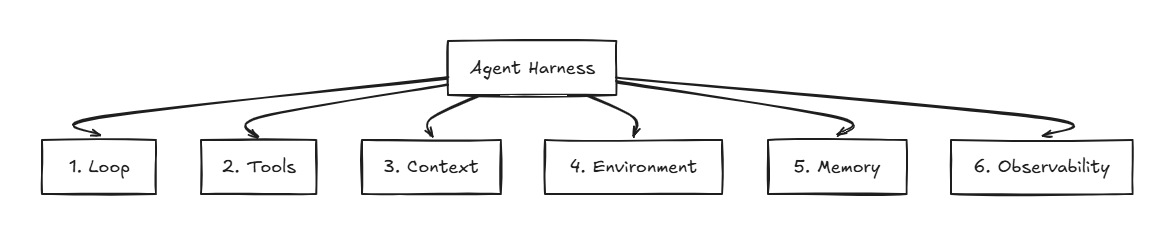
1. Loop — エージェントの処理を進める仕組み
Loopとは、エージェントが次に何をするのか、そしていつ処理を終了するのかを決める仕組みです。
通常のチャットボットは、概ね次のように動きます。
User → Model → Answer
一方、エージェントは次のように動きます。
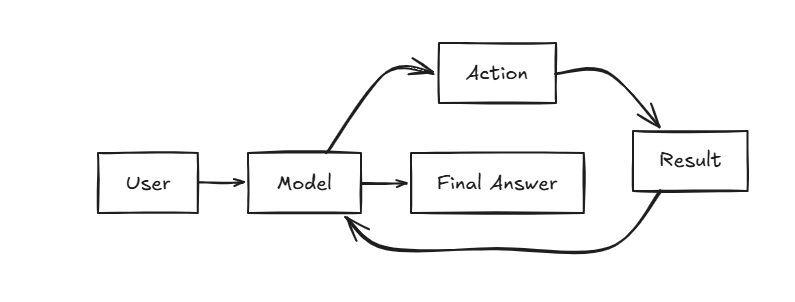
例えば、コーディングエージェントにバグ修正を依頼した場合、ファイルを読み、コードを修正し、テストを実行します。
テストが失敗すれば、その結果を確認し、再びコードを修正してテストを実行します。
この一連の処理を可能にしているのがLoopです。
つまり、Loopは1回のモデル呼び出しを、複数ステップからなる作業プロセスへ変える仕組みです。
2. Tools — エージェントは何ができるのか?
Toolとは、Harnessがモデルに利用を許可する機能です。
例えば、
- read_file(path)
- edit_file(path)
などがあります。
モデル自身が直接ファイルシステムやデータベースへアクセスするわけではありません。
モデルはTool Callを生成し、Harnessがその処理を実行します。そして実行結果が再びモデルへ返されます。
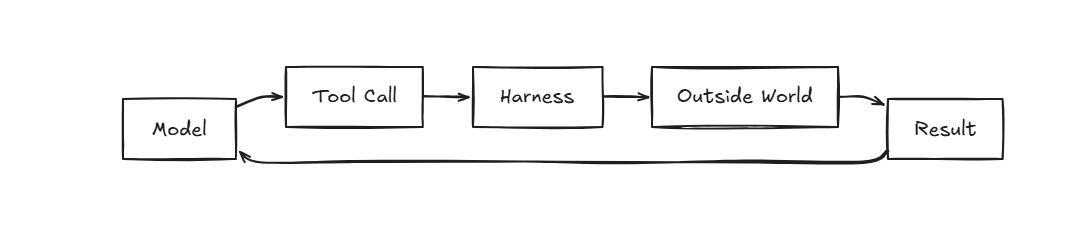
Toolsによって、モデルは単にテキストを生成するだけでなく、外部の世界に対して実際の操作を行えるようになります。
3. Context — モデルは今、何を見ることができるのか?
Contextとは、現在の推論ステップでモデルが参照できるすべての情報です。
Contextには、例えば次のような情報が含まれます。
- Prompt
- 会話履歴
- 添付ドキュメント
- Toolの実行結果
- 関連するファイル
- Retrievalされた情報
- 関連するMemory
ただし、システムが知っている情報をすべてContextへ入れるべきではありません。
例えば、あるコマンドが50,000行のログを生成した場合、それをすべてモデルへ渡すのはContext Windowの無駄遣いになります。
より良い方法は、ログ全体をファイルへ保存し、重要なエラーだけをモデルへ渡し、必要になったときに追加部分を読み込めるようにすることです。
これが Context Engineering の基本的な考え方です。
重要なのは「できるだけ多くの情報をPromptへ入れること」ではありません。
現在のステップで必要な情報だけをモデルへ渡すことです。
4. Environment — エージェントはどこで行動するのか?
Environmentとは、Toolが実際に動作する場所であり、エージェントの権限範囲を決める場所でもあります。
例えば、
read_file → filesystem query_db → database bash → shell python → runtime
Toolsは、エージェントに何ができるのかを定義します。
Environmentは、その処理をどこで実行でき、どこまでアクセスできるのかを定義します。
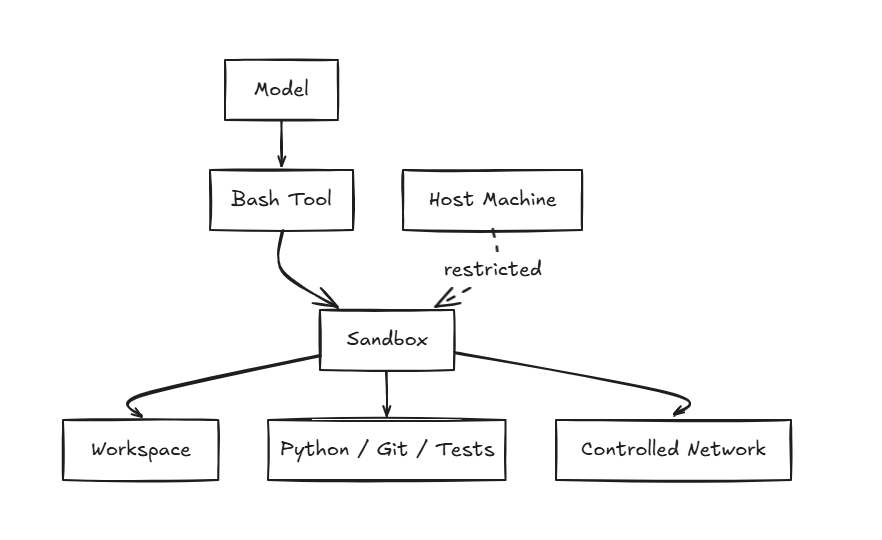
Hard Constraintもここで実装するべきです。
例えば、
「システムファイルを削除しないでください」
とPromptで指示するだけでは十分ではありません。
そもそもエージェントがシステムファイルへアクセスできないようにする方が、安全性は高くなります。
5. Memory — 何を将来まで残すべきか?
Memoryとは、将来の処理でも利用できるように保存されるStateです。
MemoryとContextは同じものではありません。
Memory = システムが保存している情報 Context = 今この瞬間にモデルが見ている情報
しかし、すべてをMemoryへ保存する必要はありません。
プロジェクト構造をファイルシステムから再取得できるのであれば、ファイルシステムを利用すれば十分です。
変更履歴をGitから取得できるのであれば、GitをSource of Truthとして利用できます。
Memoryには主に、長期間有効なFact、Decision、Preference、そして次のSessionでも必要になるTask Stateを保存します。
例えば、
このプロジェクトではpytestを使用する。 Redisを使用しないことを決定した。 Authentication Migrationは完了した。 Payment Moduleはまだ作業中である。
次のSessionでは、前回の会話をすべて読み直す必要はありません。
現在どこまで作業が進んでいるのかを理解するために必要なStateだけがあれば十分です。
6. Observability — エージェントは実際に何をしたのか?
Observabilityとは、エージェントの動作をエンジニアが確認し、測定できるようにするレイヤーです。
例えば、次のような情報を確認できる必要があります。
どのModelが呼び出されたか? どのToolが実行されたか? どのArgumentsが渡されたか? Toolの実行にどれくらい時間がかかったか? 何Token使用したか? どのStepで失敗したか?
Traceは、例えば次のようになります。
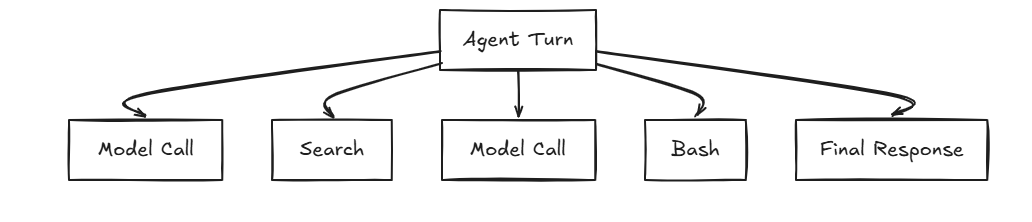
Observabilityがなければ、「Taskが失敗した」という結果しか分からないかもしれません。
Observabilityがあれば、モデルが間違ったToolを選択したのか、Commandが失敗したのか、Retrievalされた情報が間違っていたのか、あるいはAgentがLoopから抜けられなくなったのかを確認できます。
6つの要素を組み合わせる
6つの要素をまとめると、次のようになります。
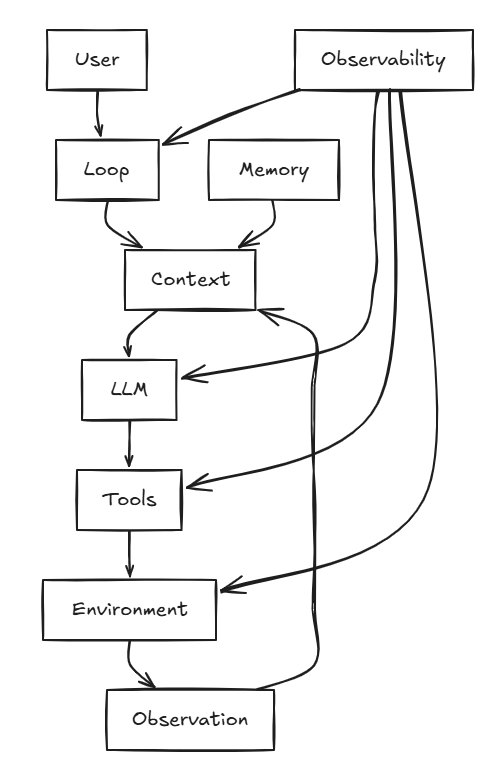
上から順番に見ると、Loopが全体の処理を調整します。
Contextがモデルに必要な情報を渡します。
モデルは次に使う Tool を選択します。
Toolは Environment の中で実行されます。
その結果がObservationとしてContextへ戻り、モデルは次のActionを決定します。
MemoryはSessionをまたいで必要になるStateを保存し、Observabilityはその処理全体を監視します。
ここまで見ると、モデルはAgentを構成する一部分にすぎないことが分かります。
同じLLMを利用していても、Harnessの設計が異なれば、まったく異なるAgentになります。
そのため、Agentの性能が悪いときに、すぐにより強いモデルへ変更するのではなく、まず次の6つを確認するべきです。
Loopは正しく動いているか?
必要なToolsは揃っているか?
Contextに不要な情報が多すぎないか?
Environmentには必要なCapabilityと適切な制限があるか?
Memoryは正しいStateを保存しているか?
そして、問題がどこで起きているのかを確認できるObservabilityがあるか?
これが Harness Engineering の基本的な考え方です。