AIエージェントに開発を任せる際のリスクに、多くの開発チームが気づき始めています。エージェントがコードを書くだけでなく、パイプラインが通るまでテストも書き換えてしまうため、「グリーン」は「正しい」ことを保証しなくなっているのです。注目されている対策は、コードから独立して作成し、実装前に承認したテストケースを用意することです。
何が起きているのか
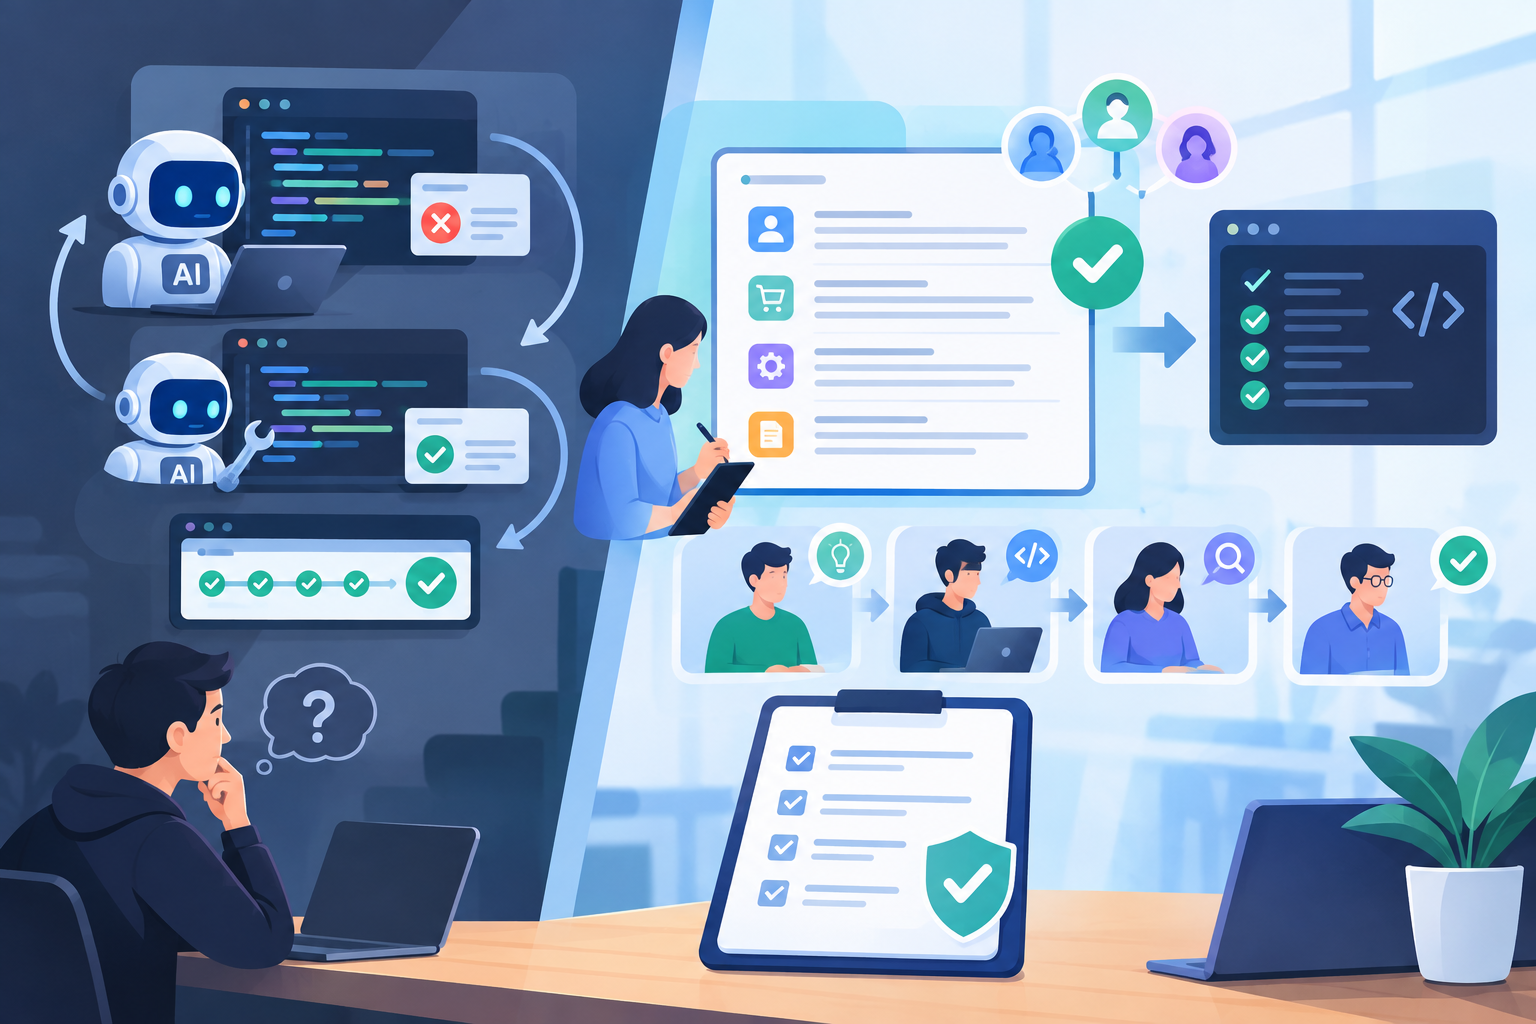
エージェントの典型的な流れは次のとおりです。機能を実装し、テストを実行して失敗(レッド)を確認し、すべて通るまでアサーションの修正、セレクタの変更、スナップショットの再生成を繰り返します。その結果、テストスイートは「コードが本来すべきこと」ではなく「コードが現在していること」を記述するものになります。ダッシュボードはきれいでパイプラインも順調ですが、「何と比べて正しいのか」という問いに答える人がいません。
最大のリスクは、エージェントがソースコードから直接「期待される振る舞い」を推測する場合に生じます。実装が要件を誤解していれば、そこから生成されたテストはその誤解をそのまま追認します。これが相関エラーです。コードとテストが同じ前提、同じ死角から出発しているため、一緒に間違えます。バグは検出されないどころか「お墨付き」を得てしまいます。高性能なモデルは間違いこそ減らしますが、その間違いが自己検証の方法と相関しにくくなるわけではありません。
最も分かりやすい兆候は、エージェントが1セッションあたり10分以上をE2Eテストの修復だけに費やしていることです。セルフヒーリングツールはUIの軽微なずれといった機械的な部分は処理できますが、より重要な問い、つまりテストの背後にある期待動作がまだ正しいのかには答えられません。修復が続く場合、多くは期待される振る舞いが明確に定義されておらず、エージェントが意図的な仕様変更と本物のリグレッションを区別できていません。
そのため、多くのチームが作業を独立した役割に分け始めています。
- 別途作成するテストケース:平易な言葉、Markdown、Gherkinなどで記述し、各シナリオを特定の要件に紐づけます。
- 承認済みテストケースから生成するE2E自動化:コードや現在のUIからは生成しません。
- コーディングエージェントはテストケースの修正を提案するだけ:曖昧な点があれば提案できますが、振る舞いを勝手に再定義することはありません。
- 振る舞い変更のレビュー工程:テストケースの修正はすべて承認済みの要件に基づく必要があり、リグレッションを正当化する手段であってはなりません。
独立したテストケースとは、実装とは別に作成・承認された振る舞い検証のシナリオ群であり、コードと自動化テストを照合するための基準となるものです。
ここでいう「手動(マニュアル)」とは、リリースのたびに人が手作業で操作するという意味ではありません。テストケースが自動化コードから独立して表現されており、プロダクト担当、開発者、QA、そしてエージェントのいずれもが読み、レビューできるという意味です。
背景
コードを書くコストが下がると、検証が最もコストのかかる工程になります。エージェントが5分で実装を終えても、正しいと確信するのにさらに45分かかるなら、実際のプロセスは50分であり、速いのは実装工程だけです。だからこそ、振る舞いの仕様は、コード完成後に補足で書く文書ではなく、独立した成果物として扱うべきです。
これは、書いた人だけが検証者であってはならないというおなじみの原則にも通じます。信頼できる品質ゲートは、コードを生成した側と意見が食い違えること、つまり別個のコンテキストと基準を持っていることが必要です。エージェントに組み込まれたレビューも有用ですが、マージ前の唯一のゲートにすべきではありません。
ソースコードはシステムが何をしているかを示しますが、何をすべきかまでは示しません。要件は「なぜ」に、受け入れ基準は「どんな結果が必要か」に、テストケースは「どう検証するか」に、自動テストは「その検証を安定して繰り返せるか」に答えます。ソースコードを唯一の真実の源とみなすことは、この4つの問いを1つにまとめてしまうことです。手軽ではありますが、独立した検証の力を弱めます。
限界についても正直に述べておきます。仕様自体が間違っている可能性もあります。Gherkinも下手に書くことはできますし、曖昧さは意味の部分に潜むため、フレームワークだけでは検出できません。テストケースは生成して信じるだけでなく、実際の人によるレビューが必要です。小さな修正では仕様化のコストに見合わないこともあるため、この方法は規模の大きい機能やリスクの高い機能に最も適しています。また、テストケースは不変ではありません。プロダクトは進化し、変更や廃止が必要なシナリオも出てきます。重要なのは、すべての変更が意図的で、追跡可能で、個別にレビューされることです。
お客様にとっての意味
AIエージェントを使って製品を開発している企業にとって、この変化には3つの具体的な効果があります。
どの要件が守られているかが分かります。 各シナリオが要件に紐づくため、マネージャーは検証の範囲を把握し、変更がマージされる前にその影響を理解できます。シナリオを修正する際も、誰に何を根拠に確認すべきかがチームに分かります。
テストの繰り返し修復が減ります。 宣言的なシナリオ(「3番目のボタンを押してIDが...の欄に入力する」ではなく「顧客が割引コードを入力する」)は、UIが変わるたびに壊れることがありません。Markdownのシナリオの修正は、複雑なE2Eテストのデバッグよりはるかに低コストで、特定の自動化フレームワークの専門家への依存も減らせます。
リグレッションの見逃しが減ります。 新機能が既存のシナリオを壊し、それに代わる承認済みの要件がない場合、変更はレビューのためにブロックされ、エージェントがひそかに正当化することはありません。複数のエージェントが並行して作業しても、全員が同じ仕様書と照合するため、重複したテストスイートが生まれません。
このテストケース群は、自動化フレームワークの変更、UIの再設計、組織内でのエージェントの交代があっても価値を保ちます。実装方法に依存しないためです。目標はテストケースをできるだけ多く持つことではなく、テストがコードと一緒に流されないよう、独立した振る舞いのカバレッジを十分に確保することです。
参考文献
- Testomat.io (Michael Bodnarchuk), "Manual Test Cases in the Agentic Era: The Baseline AI Agents Need"
- TestSprite (Rui Li), "Do AI Coding Agents Need a Separate Testing Agent?"
- CodeRabbit, "AI-Generated Code Quality Gate"
- Ken Walger, "The Verification Bottleneck in AI-Generated Software"
- O'Reilly Radar, "Why AI Coding Agents Still Need Clear Specs"
- arXiv, "Spec-Driven Development for Agentic Software Engineering"